Appearance
厚仁科技 出口成章
2024-10
JD
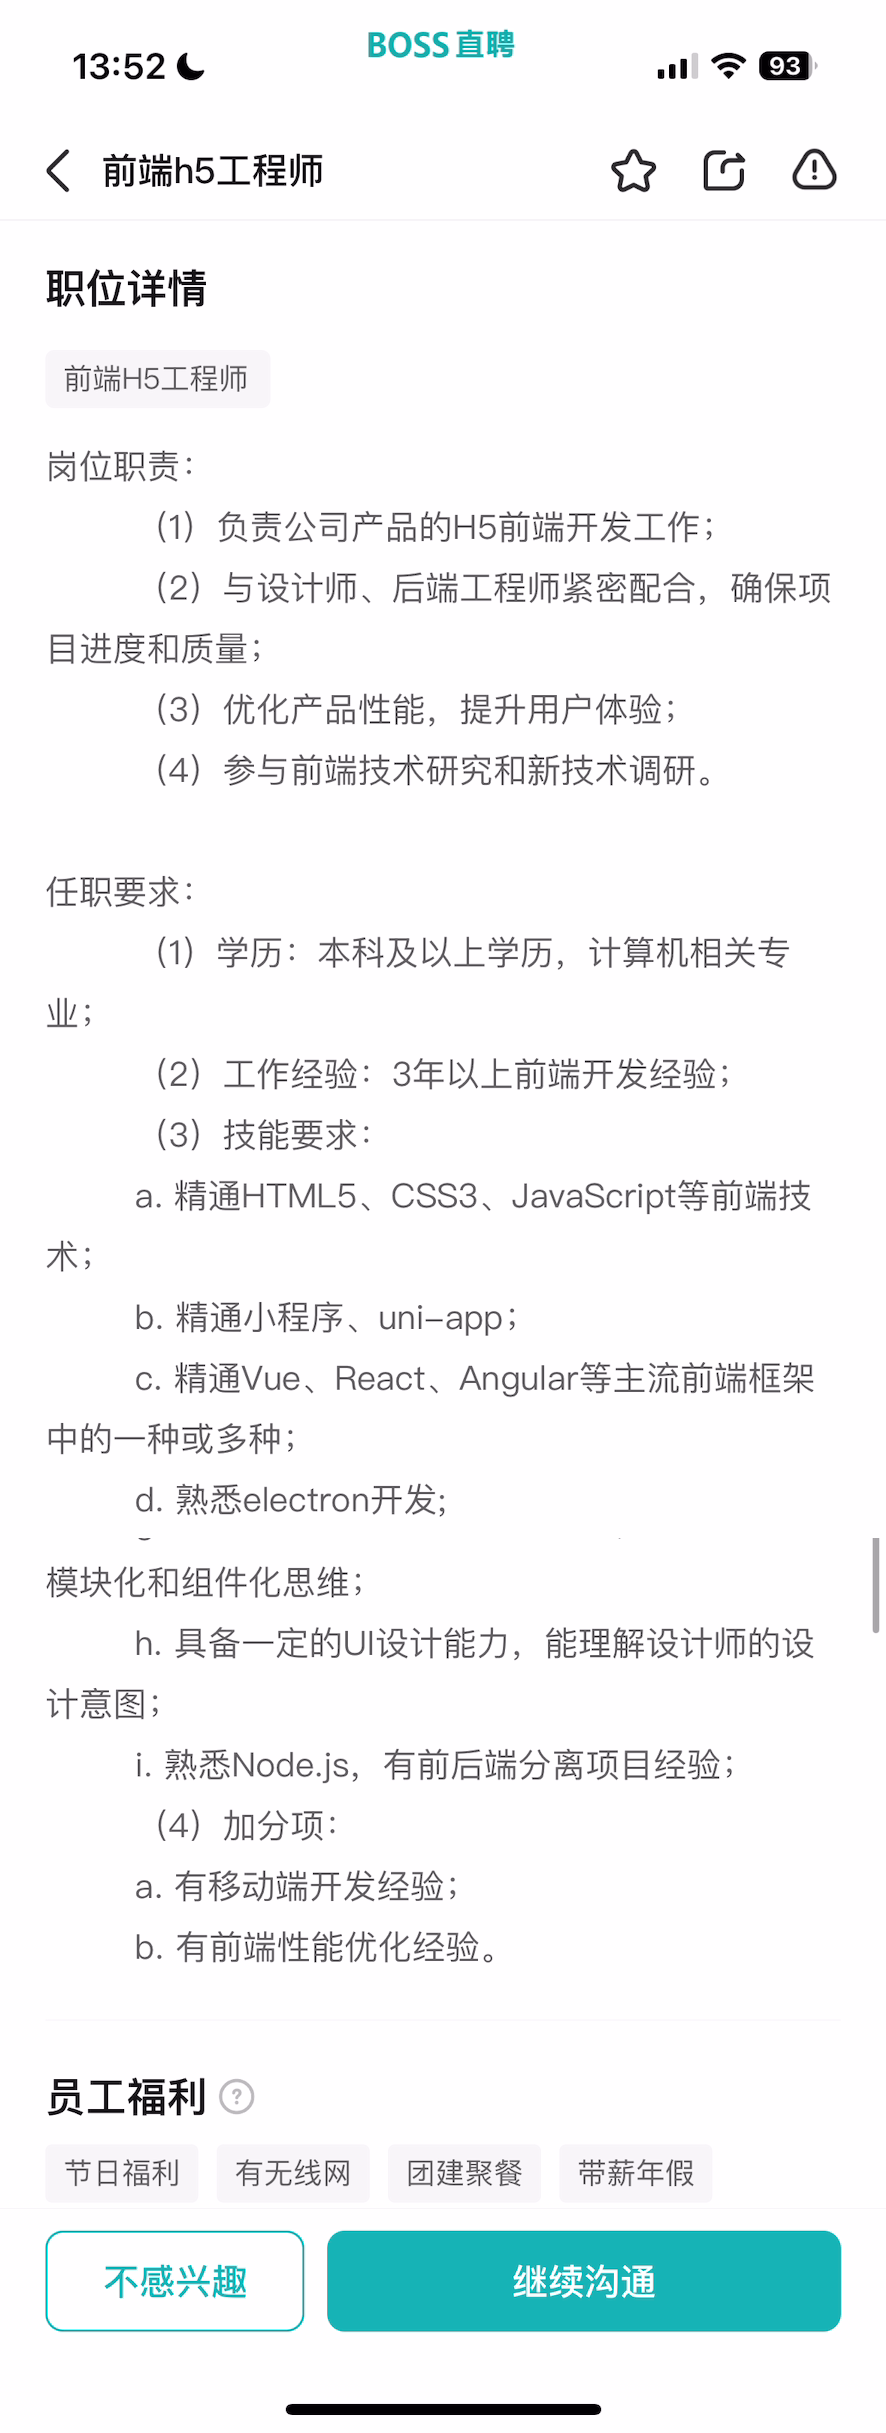
面试准备
HTML5、CSS3、JavaScript
小程序、uni-app
原生小程序、Taro.js
uniapp:提供一个app基座,用 Vue 写 app 或小程序。
Vue、React、Angular 主流框架
主要是 Vue,3 和 2 都行。
electron
一个 Chrome 内核和jsbridge,和一套 js api。
缺点是太大,写多小一个应用都得带一个几百兆的 Chrome。
Node.js
egg.js,express.js,nuxt.js。
还有平时的脚手架也都是 nodejs 的。
移动端开发经验
flutter
写过一点 swift
前端性能优化
2024-5 长亮科技 前端面试 - 对webpack做过哪些优化
代码分割、按需加载
tree shaking
摇树优化,去掉没用的代码。
代码压缩
提取 css 代码,使用 babel-loader 缓存机制减少构建时间。
并行构建
webpack 缓存
懒加载 预加载
压缩图片等资源
面试中
自我介绍
vue3 有哪些更新
组合式 API
删除了 on off once、过滤器、children
ChatGPT
性能提升。 得益于虚拟 DOM 的改进和编译优化。
组合式 API 便于拆分逻辑和复用。
基于 Proxy 的响应式系统 能检测更多种类的数据变化,解决了 Vue 2 中的一些限制(无法检测到属性的添加和删除)
- Fragment:允许组件返回多个节点,而不需要使用额外的 DOM 元素包裹。
- Teleport:允许将组件渲染到指定位置。
- Suspense:提供对异步组件的支持,可以在数据加载完成之前显示占位内容。
提供摇树优化
TypeScript 支持
全局 API 改动
Vue.mixin、Vue.component、Vue.use被移至新的 app 实例方法中。允许创建自定义渲染器。
改进了合并策略。
provide、inject。
vue3 为什么提倡 ref,好处是什么
从观察者换为了 Proxy,不需要遍历整个对象。
ChatGPT
灵活性 ref 允许在任意位置定义响应式数据,而不是只能在 data 中。
非对象类型 ref 允许对基本类型定义响应式数据。
更好的类型推断
保持响应式引用的一致性 修改对象时仍然能保持一致性,解决了 Vue2 中的一些问题。例如向对象中添加或删除属性时无法被检测。
避免因解构丢失响应式 Vue2 中解构 data 对象则会丢失响应性,Vue3 中使用
.value可以访问响应式变量的值,避免了丢失响应性的问题。
总结: Vue 3 提倡使用 ref 的原因是它提供了更灵活、更精细的响应式处理方式,尤其在组合式 API 中,它使代码的可重用性和模块化变得更加容易,同时还具备出色的类型支持和性能改进。
ref 用什么提供的代理对象,Vue 2 是怎么处理的?二者在兼容性上有什么区别。
- vue2 支持 ie11,vue3 不支持
ChatGPT
Vue3 中使用 ES6 的 Proxy 机制提供代理对象,而 Vue2 是使用 Object.defineProperty 来实现响应式系统。
Vue2 的做法:
javascript
let obj = { count: 0 };
Object.defineProperty(obj, 'count', {
  get() { ... },  // 监控访问操作
  set(value) { ... }  // 监控修改操作
});兼容性差异
Proxy 是 ES6 的新特性,所以在 IE11 中使用。Vue3 也明确不支持 IE11。
由于 Proxy 可以全面检测对象操作,所以在处理深层嵌套和复杂对象时效率更高。Vue2 是对对象进行递归处理,有性能问题。
动态属性处理:Vue2 无法监听对象内属性的新增和删除,需要使用
Vue.set和Vue.delete来手动处理。Vue3 使用Proxy处理,则天生支持。
总结
总结
- Vue 3 使用 Proxy 提供了更强大、灵活的响应式系统,可以拦截所有操作并且支持动态属性的响应式。
- Vue 2 使用 Object.defineProperty,在处理对象动态添加属性时相对局限。
- 在兼容性上,Vue 3 因为使用 Proxy,放弃了对 IE11 的支持。
vue2 到 vue3 的 diff 算法有哪些变化
ChatGPT
- 静态提升
Vue3 模板编译时,会将不会变化的静态节点提升,之后的渲染过程中直接复用。Vue2 没有。
- Block Tree 优化
Vue3 通过创建 Block Tree 来标记动态节点,这样就只会针对可能变化的节点进行更新。
Vue2 的 Diff 对模板进行全局 diff,不区分动态和静态,不管某些节点变化不变化,Diff 依然会遍历。
- 动态节点 Patch 优化
Vue 3 专注于仅更新变化的部分。由于 Block Tree 的优化,Vue 3 的 Patch 过程只会对涉及动态内容的节点进行处理,而不会处理静态的部分。对于没有变化的节点,可以直接跳过。
在 Vue 2 中,Patch 的过程是针对整个虚拟 DOM 树的,即使有些部分没有变化,也会触发比较操作。
- 事件处理优化
Vue 3 对事件监听器的处理也得到了优化。它会为每一个事件创建特定的处理函数,并在每次渲染时比较事件处理函数的引用,从而避免不必要的事件解绑和重新绑定。
Vue 2 的事件监听器会每次都进行重新绑定,导致了一些性能的浪费。
- Fragment 和 Text Diff
Vue 3 引入了Fragment,允许组件或模板返回多个根节点,而不是单个根节点。Diff 算法可以有效地处理这些 Fragment,同时 Text Diff 也得到了优化,使得多个文本节点的比较更加高效。
Vue 2 只支持单个根节点,Diff 过程中也没有对 Fragment 的处理优化。
- 更小的虚拟 DOM 结构
Vue 3 的虚拟 DOM 结构比 Vue 2 更加紧凑和高效,减少了不必要的开销。Vue 3 通过将 Diff 算法的结构进行简化,加速了虚拟 DOM 的操作。
- 对 Keyed Diff 的优化
在 Vue 3 中,Keyed Diff 的算法得到了优化,减少了同级别节点重新排序的计算开销。这使得 Vue 3 在处理带有 key 的列表时性能表现更好。
Vue 2 的 Keyed Diff 相对没有那么优化,可能会带来额外的计算开销。
- v-if 和 v-for 的处理优化
Vue 3 针对 v-if 和 v-for 结构做了优化,在这些条件语句下的节点不会像 Vue 2 那样每次都进行完整的 Diff 比较,从而提升了渲染效率。
总结
Vue 3 的 Diff 算法相比 Vue 2 更加智能、高效,主要体现在:
- 静态节点提升。
- Block Tree 使得动态节点的更新更精准。
- 动态节点和静态节点的优化处理,减少不必要的 DOM 操作。
- 更高效的事件处理和 Text Diff。
这些改进使得 Vue 3 在性能上有了显著提升,尤其是在大型项目中能够减少渲染和更新时的性能开销。
前端技术选型是根据什么选的
- 团队成员支持度
- 市面上其它产品普及程度
- 社区支持程度
前端代码优化,是固定什么时间优化,还是 code review 优化?
前端代码优化具体怎么做的
讲了讲当时在 kpmg 做的代码压缩。
有没有针对项目的具体设计和架构进行优化
针对项目的具体设计进行优化,例如对图片针对优化。
Taro.js 项目,二手的还是新的。用的 react 还是 vue?
公司内二手的,自己也做过新的。
vue。
大屏项目,初始化时上百个请求,得两分钟才能请求到。要怎么优化。
加 loading,按数据重要性依次加载。
ChatGPT
在大屏项目中,如果初始化时发送上百个请求导致性能瓶颈并且耗时过长,优化方案可以从以下几个方面入手:
请求合并(Batching Requests) 将多个相似或相关的 API 请求合并成一个请求。例如:
- 如果有多个请求获取相似的数据(如获取用户信息、批量数据等),可以将这些请求合并到一个接口中,减少请求数量。
- 使用 GraphQL 替代 REST API,可以将多个查询合并到一个请求中,从而一次性获取多组数据。
懒加载(Lazy Loading) 不要在初始化时一次性请求所有数据,而是根据用户的实际操作和需求加载必要的数据。比如:
- 分步加载:将请求的数据按优先级分阶段获取,先加载首屏数据,用户互动后再加载其他部分。
- 滚动加载:只在用户滚动到某个区域时加载更多数据(类似于分页)。
数据缓存
- 浏览器缓存:对不经常变化的数据可以使用浏览器缓存机制(HTTP 缓存头、服务端返回的 ETag 等)。
- 前端缓存:将一些静态数据存储在内存中或使用缓存库(如
localStorage、SessionStorage、IndexedDB 等)减少重复请求。 - CDN 缓存:如果请求数据是静态资源或较大的文件,使用 CDN 提高加载速度。
请求并发控制
- 限制并发数:通过并发控制工具(如
axios.all或 Promise 并发限制)限制一次发起的请求数量,避免浏览器同时发送过多请求,导致阻塞。 - 请求分片:将大批量请求按一定规则拆分为更小的批次,分批发送。
- 限制并发数:通过并发控制工具(如
使用 WebSocket 或长轮询 如果数据是实时更新的,可以考虑使用 WebSocket 代替频繁的 HTTP 请求,通过持续的连接来接收数据推送,而不是每次都需要重新发起请求。或者通过 长轮询 来减少重复的请求。
服务端优化
- 减少查询时间:优化后端查询逻辑,减少每个接口的响应时间,例如使用数据库索引、减少复杂查询等。
- 接口合并:在服务端合并多个接口的请求,减少前端需要发起的 API 调用次数。
预加载与数据预处理
- 预加载重要数据:提前加载项目启动时需要的关键数据(例如通过静态文件加载配置)。
- 数据压缩:对传输的数据进行压缩(如 JSON 压缩、使用 Gzip 或 Brotli),减少网络传输时间。
服务端分页与条件筛选 对于大量数据的请求,可以在服务端进行分页处理,或者增加条件筛选,只返回当前页面或视图需要的数据,避免一次性获取过多数据。
SSR/静态渲染 对于首屏的数据,可以通过服务端渲染(SSR)或静态生成 HTML,将部分页面数据直接渲染到页面上,减少首次加载时的 API 请求。
前端异步组件 Vue 3、React 等框架都支持异步组件,可以按需加载某些组件,这样在渲染大屏项目时可以先显示最重要的部分,减少不必要的初始加载。
总结:
以上方案可以组合使用,根据你的具体业务场景进行优化。总的来说,减少请求数量、控制并发、缓存和懒加载是应对初始加载时大量请求的有效手段。这不仅可以提升用户体验,还能减轻服务器压力。
浏览器并发请求最大数量
不知道
ChatGPT
浏览器的并发请求数量受限于浏览器的连接数限制,也就是同一时间对同一域名(域)发起的并行 HTTP 请求数量。这个数量取决于具体的浏览器和网络协议(HTTP/1.1、HTTP/2等)。以下是一些常见浏览器的并发请求限制(针对 HTTP/1.1 协议):
- Chrome: 6 个并发请求
- Firefox: 6 个并发请求
- Safari: 6 个并发请求
- Edge: 6 个并发请求
- Internet Explorer 11: 6 个并发请求
HTTP/2 的改进
在 HTTP/2 协议中,浏览器的并发请求性能有了显著的提升,允许一个连接复用多个请求,减少了对并发连接数的限制。不过,由于服务器和客户端之间的带宽和负载因素,仍然建议不要在初始化时一次发送过多的请求,而是尽量合并请求或进行优化。
总结
浏览器在 HTTP/1.1 中通常对同一域名的并发请求限制在 6 个左右,而 HTTP/2 通过连接复用,极大改善了并发性能。但在大屏项目中,优化请求的方式(如懒加载、合并请求等)仍然是最佳实践。
跨标签页通信
postMessage
借助后端,两个标签页同时使用 ws 进行通信。
ChatGPT
跨标签页通信可以通过以下几种方式实现:
localStorage+storage事件localStorage是一个用于跨标签页共享数据的简单方式。当一个标签页中的localStorage数据发生变化时,其他标签页会收到storage事件,从而实现通信。
步骤:
- 标签页 A 向
localStorage写入数据:javascriptlocalStorage.setItem('message', 'Hello from Tab A'); - 标签页 B 监听
storage事件:javascriptwindow.addEventListener('storage', (event) => { if (event.key === 'message') { console.log(event.newValue); // 获取 A 标签页传递的数据 } });
注意:storage 事件只有在数据更新时才会触发,且不会在同一标签页内触发。
BroadcastChannelAPIBroadcastChannel是一种现代浏览器提供的用于跨标签页或同一浏览器进程中不同窗口间通信的 API。它非常方便,支持多个页面之间的实时通信。
步骤:
- 在每个标签页中创建同一个频道:javascript
const channel = new BroadcastChannel('my_channel'); - 标签页 A 向频道发送消息:javascript
channel.postMessage('Hello from Tab A'); - 标签页 B 监听频道消息:javascript
channel.onmessage = (event) => {
  console.log(event.data);  // 收到来自 A 的消息
};
SharedWorkerSharedWorker允许多个浏览器窗口、标签页或 iframe 共享一个工作线程,因此可以通过它在多个标签页之间进行通信。
步骤:
创建一个
SharedWorker:javascriptconst worker = new SharedWorker('worker.js'); worker.port.postMessage('Hello from Tab A'); worker.port.onmessage = (event) => { console.log(event.data); // 从其他标签页收到消息 };在
worker.js中处理消息:javascriptonconnect = (event) => { const port = event.ports[0]; port.onmessage = (e) => { port.postMessage(`Received: ${e.data}`); }; };
window.postMessage+window.open当你通过window.open打开新的窗口或者标签页时,可以使用postMessage实现通信。父窗口和子窗口可以通过该方法互相发送消息。
步骤:
- 父窗口打开子窗口,并发送消息:javascript
const child = window.open('child.html'); child.postMessage('Hello from Parent', '*'); - 子窗口监听消息:javascript
window.addEventListener('message', (event) => {
  console.log(event.data);  // 从父窗口接收消息
});
Service WorkerService Worker是一种中间层代理,可以处理所有标签页对某些资源的请求,因此也可以用于跨标签页通信。
标签页 A 向
Service Worker发送消息:javascriptnavigator.serviceWorker.controller.postMessage('Hello from Tab A');Service Worker中处理消息,并广播给所有连接的标签页:javascriptself.addEventListener('message', (event) => { clients.matchAll().then(clients => { clients.forEach(client => { client.postMessage(event.data); }); }); });
总结
这些方法都适用于不同场景,具体选择取决于应用需求以及兼容性要求。BroadcastChannel 是目前最简单、有效的解决方案,而 localStorage 则更为普遍。
随便讲讲 Promise、async/await
- 处理异步
- 解决回调地狱问题
- 链式调用,.then
为什么可以链式调用
因为 Promise 对象下有 .then
ChatGPT
Promise 可以链式调用的原因在于其内置的机制,即 then() 方法返回的仍然是一个 Promise 对象。通过这种设计,Promise 的 then() 方法允许在异步操作完成后进行处理,并且可以返回一个新的 Promise,从而使得后续的操作可以继续等待这个新的 Promise 的结果。
具体机制:
then()方法返回一个新的Promise对象: 当调用promise.then()时,then()方法会返回一个新的Promise,该Promise会根据当前的Promise是否成功(resolved)或失败(rejected)来决定其状态。无论你在then()方法中返回一个值(普通值或者新的Promise),都会生成一个新的Promise。javascriptlet promise = new Promise((resolve, reject) => { resolve(1); }); promise .then((result) => { console.log(result); // 1 return result * 2; }) .then((result) => { console.log(result); // 2 });捕获错误并继续链式调用: 如果
then()或catch()中发生错误,返回的Promise也会进入rejected状态,从而触发后续链式调用中的catch()方法进行错误处理。这种方式确保了代码可以按照顺序处理多个异步任务,而不需要嵌套回调函数。javascriptlet promise = new Promise((resolve, reject) => { reject("error"); }); promise .then((result) => { console.log(result); }) .catch((error) => { console.log("Caught:", error); // Caught: error }) .then(() => { console.log("This will still run even after error."); });异步任务的串联: 链式调用允许你把多个异步操作串联起来。每次调用
then(),都会等待上一个Promise的结果,并将结果传递给下一个then(),从而实现异步任务的顺序执行。javascriptfetch('https://api.example.com/data') .then(response => response.json()) .then(data => { console.log('First API data:', data); return fetch('https://api.example.com/other-data'); }) .then(response => response.json()) .then(otherData => { console.log('Second API data:', otherData); }) .catch(error => console.error('Error:', error));
总结
Promise 能够链式调用的关键原因在于每次调用 then() 方法时,都会返回一个新的 Promise 对象,这使得下一个 then() 可以在前一个 Promise 处理完毕后继续执行,形成链式结构。这种设计使得异步流程控制更加清晰、简洁,避免了“回调地狱”的问题。
Promise 和 async/await 好坏
看具体场景,没有谁好谁坏。
ChatGPT
Promise 和 async/await 是 JavaScript 中处理异步操作的两种主要方式。它们各有优缺点,适用于不同的场景。
Promise 的优缺点
优点:
链式调用:
Promise可以通过.then()方法链式调用,使得异步操作的顺序更加直观,不需要回调地狱。javascriptfetch(url) .then(response => response.json()) .then(data => console.log(data)) .catch(error => console.error(error));更清晰的错误处理: 使用
catch()方法可以捕获错误,并且适用于整个链条,简化了错误处理的复杂度。并行处理: 使用
Promise.all()等方法可以方便地并行处理多个异步任务,只有在所有任务都完成后才继续处理结果。javascriptPromise.all([fetch(url1), fetch(url2)]) .then(responses => console.log('All completed:', responses)) .catch(error => console.error(error));
缺点:
代码结构不够简洁: 即使通过链式调用,代码结构仍然显得有些复杂,尤其是当涉及多个异步操作时,嵌套的
.then()可能让代码变得难以维护。难以同步化思维:
Promise是异步的,所以它对于习惯同步思维的开发者而言可能不直观,特别是当你需要执行一系列顺序任务时,阅读和理解链式.then()可能会变得困难。
Async/Await 的优缺点
优点:
更接近同步代码:
async/await允许你编写异步代码的方式类似于同步代码,代码更清晰、直观,易于阅读。javascriptasync function fetchData() { try { const response = await fetch(url); const data = await response.json(); console.log(data); } catch (error) { console.error(error); } }更清晰的错误处理: 使用
try/catch块来捕获错误,逻辑上比Promise的then/catch更统一和清晰。代码扁平化: 相较于
Promise链式调用的嵌套结构,async/await扁平化了代码结构,避免了回调嵌套问题,使异步流程更容易维护。适合顺序执行的任务: 当任务之间存在顺序依赖时,
async/await更适合,因为它会等待每一个异步任务完成后再执行后续代码,简化了逻辑。
缺点:
没有并行特性:
async/await更适合顺序执行,如果需要并行处理多个任务,仍然需要使用Promise.all(),否则会导致不必要的性能损耗。javascript// 如果使用 async/await 会按顺序执行,较慢 const result1 = await fetch(url1); const result2 = await fetch(url2); // 使用 Promise.all 并行执行 const [result1, result2] = await Promise.all([fetch(url1), fetch(url2)]);旧浏览器不支持:
async/await在较老的浏览器中不被支持,可能需要使用 Babel 或类似的工具进行转换。
何时使用 Promise 和 Async/Await
使用
Promise:当你需要并行执行多个异步操作时,例如使用Promise.all(),Promise会更高效,特别是在处理多个请求时。使用
async/await:当异步操作需要顺序执行,并且你希望让代码更接近同步风格时,async/await是更好的选择。它的语法更简洁,错误处理也更方便。
总结
- Promise 更适合复杂的异步操作和并行任务。
- Async/Await 更适合顺序执行任务,代码简洁且易读。
vue 中数据绑定原理,数据变化时用什么方式进行监听
双向绑定,单项数据流。
vue2 obs...,vue3 proxy
ChatGPT
在 Vue 中,数据绑定是通过响应式系统实现的,主要通过数据劫持和依赖追踪来监听数据的变化,并更新视图。Vue 2 和 Vue 3 的实现方式有所不同,Vue 2 主要依赖 Object.defineProperty,而 Vue 3 则通过 Proxy 进行优化。
Vue 2 数据绑定原理
在 Vue 2 中,数据绑定的核心机制是使用 Object.defineProperty 实现的 getter 和 setter。这个机制允许 Vue 拦截对象属性的访问和修改,从而实现数据变化时的监听和视图更新。
具体流程:
- 数据劫持:当你在 Vue 实例的
data选项中声明数据时,Vue 会遍历对象的每个属性,并使用Object.defineProperty把这些属性转化为 getter 和 setter。 - 依赖追踪:当组件渲染时,Vue 的依赖追踪系统会记录下该组件所依赖的数据。
- 变更检测:当用户修改数据时,setter 会被触发,并通知相关的依赖去重新计算或更新视图。
例如,当你修改一个对象属性时,Vue 会自动触发 setter,通知 DOM 重新渲染。
局限:
Vue 2 的 Object.defineProperty 方案有一些局限,比如它无法直接监听数组的变动,也无法检测新增或删除对象的属性。因此 Vue 2 需要特殊处理这些情况,像是通过数组的变异方法(如 push、splice)来监听数组变化,或者使用 Vue.set() 动态添加新属性。
Vue 3 数据绑定原理
在 Vue 3 中,Vue 改用了 Proxy 来进行数据劫持。Proxy 相比于 Object.defineProperty 更加强大,能够监听对整个对象的所有操作,包括新增、删除属性,以及数组索引和长度的变化。
具体流程:
- Proxy 拦截:Vue 3 会对整个
data对象进行代理,使用Proxy拦截对该对象的读写操作。 - 依赖追踪和变更检测:类似 Vue 2,Vue 3 也有依赖追踪系统,但它的变更检测更加灵活,不再受
Object.defineProperty的局限。
优点:
- 可以监听对象的属性新增、删除操作。
- 对数组的操作更加灵活,任何数组变动都能被自动检测。
- 性能提升,尤其是在处理复杂对象时。
数据变化的监听方式
Vue 中数据变化的监听是通过发布-订阅模式实现的。数据改变后会触发依赖(也就是观察者)的更新,从而重新渲染视图。这一机制在 Vue 2 和 Vue 3 中都保持一致,只是实现细节有所不同。
- 在 Vue 2 中,当某个属性的值发生变化时,会通过 setter 通知所有依赖该属性的组件重新渲染。
- 在 Vue 3 中,
Proxy代理对象的 setter 负责捕获属性的变化,并通知视图进行更新。
总结:
- Vue 2 通过
Object.defineProperty劫持对象属性的 getter 和 setter。 - Vue 3 使用
Proxy代理整个对象,监听对象及其属性的各种操作。 - 两个版本都使用依赖追踪和发布-订阅模式来响应数据变化并更新视图。
这两种方案的目的都是为了解决数据与视图同步的问题,但 Vue 3 的实现更灵活、高效,适应更多复杂场景。
created 和 mounted 的区别
创建实例和挂载。
ChatGPT
created 和 mounted 是 Vue 生命周期中的两个不同阶段,它们在组件初始化和 DOM 渲染过程中分别起到不同的作用。
1. created
created 钩子函数在实例创建之后立即调用,此时组件的数据已被观察(响应式),但是DOM 还未生成。这意味着在 created 阶段可以访问和修改组件的数据、执行异步请求(如 API 请求),但无法操作或访问 DOM 元素。
适合的场景:
- 初始化数据
- 异步获取数据(例如通过 API 获取远程数据)
- 不依赖 DOM 的逻辑初始化工作
限制:无法访问组件的 DOM(因为此时 DOM 还没有渲染)。
javascript
created() {
  console.log('数据已经初始化了');
  console.log('但 DOM 还未渲染');
  this.fetchData();
}2. mounted
mounted 钩子函数在组件挂载完成之后调用,即组件的模板已经被渲染到了页面上,DOM 已经生成,数据和 DOM 都可以访问。
适合的场景:
- 操作 DOM 元素
- 依赖于 DOM 的逻辑(如设置滚动条位置、获取元素大小)
- 使用第三方 DOM 库(如图表、滑动组件等)
限制:只能在 DOM 渲染完成后执行,与渲染相关的操作不能放在
created阶段。
javascript
mounted() {
  console.log('组件已经挂载到 DOM 中');
  console.log('可以操作 DOM 了');
  this.initializeChart();
}总结
created适合处理与数据有关的逻辑,但不能操作 DOM。mounted则可以处理与 DOM 有关的操作。
因此,Vue 的 created 更适合初始化数据和逻辑,而 mounted 则是用于处理渲染后的操作。
大数据量渲染优化
虚拟列表
iframe 嵌入本地 html 页面,切换时白屏怎么优化。代码性能上,怎么解决白屏问题。
ChatGPT
嵌入本地 HTML 页面时出现白屏,通常是由于加载页面时的渲染延迟或资源加载不完全导致的。优化 iframe 切换时的白屏问题,可以从以下几个方面入手:
1. 预加载资源
确保在页面加载前,所有资源(CSS、JS、图片等)已经准备就绪,避免加载过程中出现空白。例如,使用以下方法预加载:
html
<link rel="preload" href="your-page.html" as="document">这样可以在切换 iframe 内容之前加载资源,减少白屏时间。
2. 减少 DOM 操作和渲染
优化嵌入的页面结构,减少不必要的 DOM 操作和过度的 JavaScript 渲染,确保 iframe 页面能更快速地完成初始渲染。简化 HTML 结构和减少不必要的重绘、重排操作。
3. 使用占位符或加载动画
在 iframe 切换时,显示一个占位符或加载动画,提升用户体验。在 iframe 正在加载时,显示一个视觉反馈,避免页面空白。
html
<iframe id="iframe" src="about:blank"></iframe>
<div id="loading" style="display: none;">Loading...</div>

<script>
  const iframe = document.getElementById('iframe');
  const loading = document.getElementById('loading');

  iframe.addEventListener('loadstart', () => {
    loading.style.display = 'block';  // 显示加载动画
  });

  iframe.addEventListener('load', () => {
    loading.style.display = 'none';   // 隐藏加载动画
  });

  iframe.src = 'your-local-page.html';  // 目标页面加载
</script>4. 使用双缓冲技术
类似游戏中的双缓冲技术,可以在 iframe 切换时使用两层 iframe 进行“交替显示”。先加载下一个页面到隐藏 iframe 中,当内容完全加载完成后再切换显示。
html
<iframe id="current-frame" src="your-page.html"></iframe>
<iframe id="next-frame" style="display:none;"></iframe>

<script>
  const currentFrame = document.getElementById('current-frame');
  const nextFrame = document.getElementById('next-frame');

  function loadNewPage(url) {
    nextFrame.src = url;
    nextFrame.onload = function() {
      currentFrame.style.display = 'none';
      nextFrame.style.display = 'block';
      [currentFrame, nextFrame] = [nextFrame, currentFrame];  // 交换两个 iframe
    };
  }

  loadNewPage('your-other-page.html');
</script>5. 减少网络请求时间
确保嵌入页面的资源(CSS、JS 等)已经缓存好,并且本地服务器响应速度快。如果资源较多,考虑将其合并、压缩,减少 HTTP 请求次数,提升加载速度。
6. 异步加载非关键资源
非关键资源(如非首屏可见的图片或脚本)可以使用懒加载方式。对于图片资源可以使用 loading="lazy" 属性,延迟加载提升性能。
html
<img src="image.jpg" loading="lazy" alt="Image description">7. Content Security Policy (CSP) 和跨域限制
如果你使用 iframe 加载跨域资源,要确保跨域策略配置正确,否则页面可能因为跨域问题加载失败,导致白屏。
watchEffect 和 computed 有什么区别
一个是监听,一个是计算。不是一个东西。
原理上不知道
ChatGPT
watchEffect 和 computed 都是 Vue 3 中用于响应式数据的功能,但它们在用法和实现原理上有明显的区别:
1. 用途和功能
computed:- 用于基于依赖的数据进行计算,返回一个具有缓存功能的计算属性。
computed只有在依赖数据改变时才会重新计算,其他情况下返回缓存值。 - 常用于依赖其他响应式数据并需要优化性能的场景,例如处理复杂的计算逻辑。
- 用于基于依赖的数据进行计算,返回一个具有缓存功能的计算属性。
watchEffect:- 是一种自动追踪依赖的响应式副作用。无论在执行过程中访问了哪些响应式属性,都会自动追踪并在依赖变动时重新执行。
- 常用于监听响应式数据的副作用,例如 DOM 操作、API 调用等,适合那些不需要返回值的情况。
2. 缓存机制
computed有缓存机制。如果依赖的值没有改变,访问computed计算属性时,它会直接返回上一次计算的结果,而不会重新计算。这对性能优化非常重要,特别是在依赖值不经常变化的情况下。watchEffect没有缓存机制。每次依赖的响应式数据变化时,watchEffect的回调函数会重新执行。这更适合处理副作用而非返回计算结果的场景。
3. 实现原理
computed通过 lazy evaluation(惰性求值) 来实现。它只有在被访问时才会计算结果,并且在依赖数据没有改变时,返回的是缓存的结果。Vue 通过getter/setter和内部的依赖追踪机制来检测依赖的变化并更新结果。watchEffect是 即时运行的,它在组件渲染过程中会自动依赖响应式数据。Vue 内部会追踪依赖的响应式数据,一旦这些数据发生变化,watchEffect的副作用函数就会重新执行。它的实现类似于 Vue 2 中的watch,但它自动捕捉依赖,不需要手动指定依赖项。
4. 使用场景
computed适合用于根据响应式数据计算结果,并且希望这个结果具有缓存效果时使用。它是“纯计算”功能,没有副作用。watchEffect适合需要在响应式数据变化时执行副作用操作的场景,比如操作 DOM、发送网络请求、或手动管理其他外部系统的状态。
5. 示例
computed:jsconst count = ref(1); const doubled = computed(() => count.value * 2);watchEffect:jsconst count = ref(1); watchEffect(() => { console.log(`Count changed: ${count.value}`); });
总结:
computed是一个基于依赖的缓存计算属性,适合用来计算并返回结果。watchEffect是一个处理副作用的自动追踪响应式函数,适合需要执行额外逻辑或操作的场景。
组件的 key 值的作用
是组件的唯一 id,可以通过修改 key 来重新加载组件。
ChatGPT
在 Vue 中,key 是一个特殊的属性,通常用于提高渲染列表时的性能,并确保组件在 DOM 中保持唯一性。它的主要作用包括以下几点:
1. 唯一标识:
当 Vue 渲染一个列表(例如通过 v-for 指令)时,key 提供每个列表项的唯一标识符。这有助于 Vue 在进行 DOM diff 算法时精确跟踪每个元素,确保 Vue 知道哪些元素被添加、更新或删除。
2. 优化更新:
通过给每个元素指定唯一的 key,Vue 可以有效区分哪些元素是新的,哪些是已有的,从而避免不必要的 DOM 操作。对于没有 key 的列表项,Vue 会根据默认的顺序来进行猜测性的比较,这可能会导致不必要的更新和性能下降。
3. 避免重用错误:
如果在渲染相同类型的组件时没有指定 key,Vue 可能会错误地重用组件实例,导致数据的错位或状态的不一致。例如,在表单输入中没有正确设置 key,可能导致用户输入的数据错误地共享给多个表单项。
4. 强制重新渲染:
在某些场景下,可以通过改变 key 的值来强制组件重新渲染。例如,当路由发生变化时,你可以通过设置不同的 key 值来确保不同路由页面之间不会复用同一个组件实例。
例子:
vue
<template>
  <div>
    <ul>
      <li v-for="item in items" :key="item.id">{{ item.name }}</li>
    </ul>
  </div>
</template>在这个例子中,key="item.id" 确保每个列表项都有唯一的标识符,Vue 能够正确地跟踪和更新列表。
总结:
key用于唯一标识列表中的每个元素。- 它帮助 Vue 更高效地更新 DOM,减少不必要的重新渲染。
- 还可以防止组件错误复用,保持状态和数据的正确性。
如果没有使用 key,可能会导致性能下降或状态混乱,因此 Vue 强烈建议在渲染列表时提供 key。
准确判断数据类型
typeof 判断值类型
Object 原型链上的 toString 的字符串来判断引用类型
手写深拷贝
没背
处理循环引用
weakmap
对公司有什么想了解的
主要做什么类型的项目,2B 2C?
- 都有
2C 以 web 还是客户端为主
- 客户端
跨平台吗
协作流程
- 私有 gitlab
- 手动部署
uniapp 的生命周期函数和 vue 中有什么区别吗
不一样,基于微信小程序。
使用 uniapp 做过什么吗
大学印象,5+ runtime。
气体检测仪项目。